Krankenhausdaten aus zehn Quellen, geprüft und publikationsfertig
Eine Pipeline, die Struktur- und Qualitätsdaten deutscher Krankenhäuser zusammenführt, prüft und als schema-validiertes XML ausliefert. Dazu die Weboberfläche, über die der Fachbereich die Zuordnungen pflegt, aus denen der Export entsteht. Veröffentlicht wird das Ergebnis unter anderem im Bundes-Klinik-Atlas.
Ausgangslage
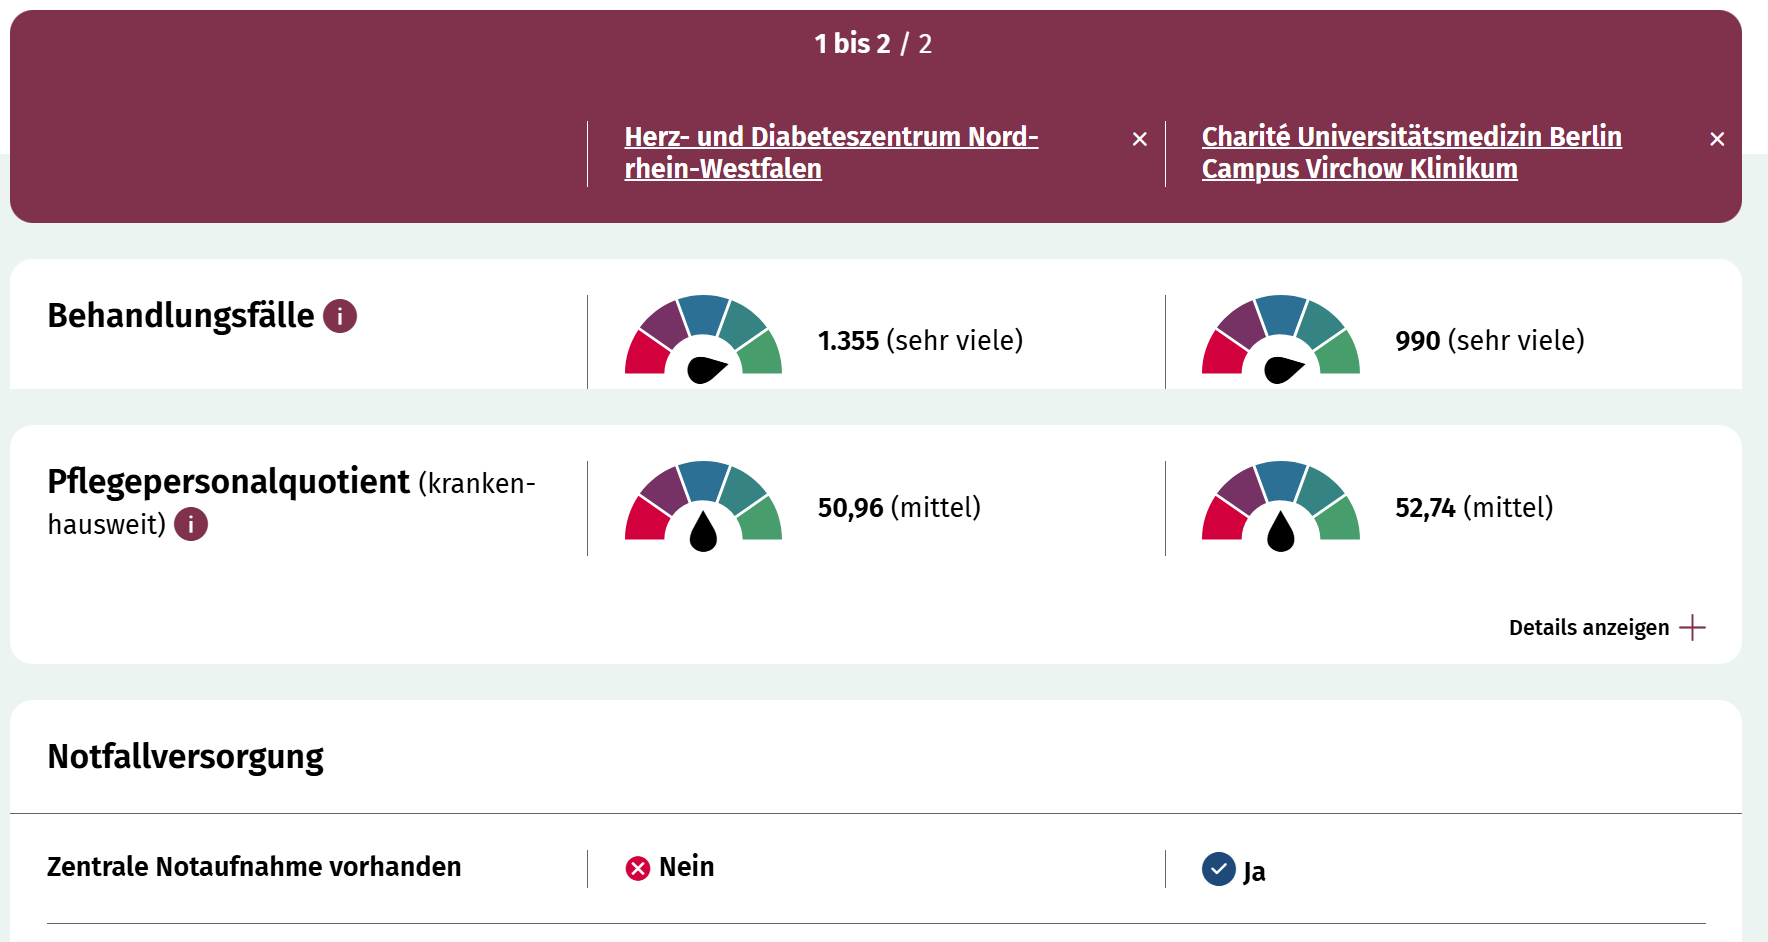
Wer im Bundes-Klinik-Atlas eine Klinik nachschlägt, sieht Fallzahlen, Qualitätsergebnisse, Zertifikate, Notfallstufe, Angaben zur Barrierefreiheit. Zusammen liegen diese Angaben nirgends. Sie kommen aus rund zehn Quellen: aus Registern, aus Auswertungsdatenbanken, über eine interne REST-API, aus Excel-Listen, die jemand von Hand abstimmt, und aus einer rechtlich verbindlichen Liste, die es nur als PDF gibt.
Alle diese Quellen benutzen dieselbe Standort-ID und sind sich trotzdem nicht einig, welche Standorte es überhaupt gibt. Ein Register meldet einen Standort als geschlossen, der noch betrieben wird. Ein anderes kennt Schließungen, die im ersten fehlen. Ein Fehler ist hier eine falsche Aussage über ein namentlich genanntes Krankenhaus.
Ziel
Ein Datenstand, der reproduzierbar entsteht, fachlich abgenommen wird und dem vorgegebenen Format entspricht. Schwierig ist vor allem das Format: Das XML-Schema kommt von außen, wird dort versioniert, und die erzeugte Datei muss dagegen validieren, sonst ist sie wertlos. Leere Werte lässt es nicht zu.
Dazu kommen zwei Empfängerkreise, die unterschiedlich viel sehen dürfen. Aus einem Lauf entstehen deshalb zwei Varianten: eine vollständige und eine, in der kleine Fallzahlen maskiert sind, weil sie sonst Rückschlüsse auf einzelne Patienten erlauben.
Lösung
Die fachliche Zuordnungslogik liegt nicht im Pipeline-Code. Welcher Qualitätsindikator zu welchem Versorgungsanlass gehört, welche Behandlungs-Kachel welche Zertifikate und Mindestmengen führt, in welcher Reihenfolge das erscheint: das steht als Daten in einer Datenbank und wird über eine Shiny-App gepflegt. Der Exportlauf liest es nur. Fachliche Änderungen brauchen dadurch kein Deployment, und das ist die wichtigste Designentscheidung des Projekts.
Der Lauf selbst holt je Quelle die neueste Lieferung aus dem aktuellsten datierten Ordner, führt zusammen, rechnet, prüft und schreibt. Parallel entsteht eine Excel-Checkliste: je Datenblock die Quelle, fehlende Werte, fehlende und ausgeschlossene Standorte, seit dem letzten Export geschlossene Häuser. Mit diesem Blatt gibt der Fachbereich frei.
Raus kommen die XML-Dateien in beiden Varianten, Aggregate über die 16 Bundesländer und den Bund, und Excel-Kopien der verwendeten Listen, alles in einem Ordner mit dem Exportdatum im Namen.
Ergebnis
„Die automatisierte Datenaufbereitung für den Bundes-Klinik-Atlas ermöglicht uns effiziente Veröffentlichungszyklen und gewährleistet dabei höchste Datenqualität. Die nahtlose Integration neuer Datenquellen und die kontinuierliche Bereitstellung aktueller Informationen sind ein wichtiger Beitrag zur Transparenz im deutschen Gesundheitswesen.“
Wo es knifflig wurde
Ein sehr großes XML gegen ein fremdes Schema
Der naheliegende Weg, pro Standort und Datenblock einen Knoten anzulegen und zu befüllen, trägt bei dieser Datenmenge nicht: Ein XML-Baum wird Knoten für Knoten teurer, je größer er schon ist. Der zweite Reflex, die Arbeit einfach auf mehrere Prozesse zu verteilen, macht es schlimmer. Einzelne Datensätze liegen über 500 MB, und die an jeden Worker zu schicken kostet mehr, als die Parallelisierung einspart. Geholfen hat am Ende, den Baum in einer anderen Reihenfolge aufzubauen und die Arbeitspakete anders zu schneiden. Die Schema-Validierung sitzt als harte Bedingung davor: eine Datei, die nicht validiert, wird nicht geschrieben.
Zehn Quellen, die sich nicht einig sind
Wer auf die Standort-ID joint und der Quelle vertraut, produziert genau die Fehler, die auf einer öffentlichen Seite am teuersten sind: ein geschlossenes Haus wird angezeigt, ein bestehendes fehlt, ein Name ist falsch. Standorte werden außerdem zusammengelegt, und dabei muss man manche Kennzahlen summieren und andere vom aufnehmenden Standort übernehmen. Eine allgemeine Lösung gibt es dafür nicht, nur eine belastbare Reihenfolge von Regeln und die Prüfung, dass jede Quelle für jeden erwarteten Standort etwas liefert. Fehlt etwas, steht es in der Checkliste statt unbemerkt im Export. Jeder Sonderfall steht im Code mit eigenem Marker und Begründung, und das ist hier die eigentliche Wartungsarbeit.
Geheimhaltung, die das Schema nicht vorsieht
Kleine Fallzahlen dürfen nicht veröffentlicht werden. Sie als NA auszugeben verletzt
das Schema, das keine leeren Werte zulässt. Die Maskierung muss also ein Wert sein, den das
Schema akzeptiert und den der Abnehmer als unterdrückt liest statt als Null. Das Maskieren selbst
ist schnell gemacht. Schwierig ist, dass jede betroffene Kennzahl über alle Datenblöcke hinweg
gleich behandelt wird und nirgends durchrutscht.
Technische Umsetzung
Die Pflegeoberfläche ist eine Shiny-App aus UI/Server-Modulen, eins pro Fachtabelle. Editiert wird
über rhandsontable, weil Massenpflege mit Dropdowns, Filtern und eingefügten Zeilen
näher an Excel liegt als an einem Webformular. Ob jemand schreiben darf, hängt an seiner
Nutzergruppe; wer nur Leserechte hat, bekommt dieselben Tabellen read-only gerendert. Geschrieben
wird in Transaktionen, jede Änderung landet mit Alt- und Neuwert, Nutzer und Zeitstempel im
Audit-Trail. Ein Eintrag, der noch anderswo referenziert wird, lässt sich nicht löschen: die App
stellt die Zeile wieder her und sagt warum.
Der Export baut den XML-Baum über xml2 auf und validiert ihn gegen das mitgelieferte
XSD, statt ein Template zu rendern. Aufbau und Validierung kommen so aus einer Hand.
Parallelisiert wird mit zwei Backends, weil die beiden Probleme unterschiedlich geschnitten sind:
future mit furrr für den XML-Export, mirai für die
statistischen Berechnungen. data.table steht nur im Hot Path, der Rest ist
durchgehend tidyverse. Ein bewusster Bruch mit dem Hausstil an der einen Stelle, an der er sich
rechnet.
Vor dem Export läuft eine Prüfung über alle Datenblöcke: Struktur, Spaltennamen, Wertebereiche,
erlaubte Werte und Beziehungen zwischen den Blöcken. Sie ist mit checkmate als
Assertion-Collection gebaut und sammelt alle Verstöße, statt beim ersten abzubrechen. Bei einem
Lauf, der Minuten kostet und am Ende ohnehin fachlich abgenommen wird, ist die vollständige
Fehlerliste mehr wert als der schnelle Abbruch. Die Verstöße landen gesammelt auf einem Blatt
der Checkliste; hart ist nur der Schema-Check.
Betrieb und Weiterentwicklung
Der Exportlauf ist ein Skript, das eine Person anstößt. Kein Scheduler. Für einen Datenstand, der vor der Veröffentlichung ohnehin fachlich abgenommen wird, ist das vertretbar, aber es bleibt eine Entscheidung.
Jeder Lauf schreibt mit, woraus er entstanden ist: die verwendeten Quellordner mit Datum und den Git-Commit des Codes, sowohl in die Checkliste als auch in eine Datenbank für Zwischenergebnisse, in der der ungefilterte Datenstand liegt. Zugangsdaten stehen nicht im Code.
Die Datenpflege ist zweigeteilt und bleibt es bewusst. Die Zuordnungen laufen über die App, jeden Tag, unabhängig vom Export. Die Eingangsdaten kommen als datierte Ordner auf ein Netzlaufwerk: hinlegen muss sie jemand von Hand, abgeholt werden sie automatisch.
Entwicklung und Pflege liegen bei mir. Gewachsen ist das über mehrere Auswertungsjahre, und jeder Jahreswechsel ist ein Stück Wartung: Erfassungs-, Berichts- und Prognosejahre laufen versetzt, Zertifikatsfristen verschieben sich, das Schema bekommt eine neue Version. Diese Konstanten stehen deshalb gesammelt am Kopf des Skripts.