Ein Jahresbericht, der fertig formatiert aus dem Lauf kommt
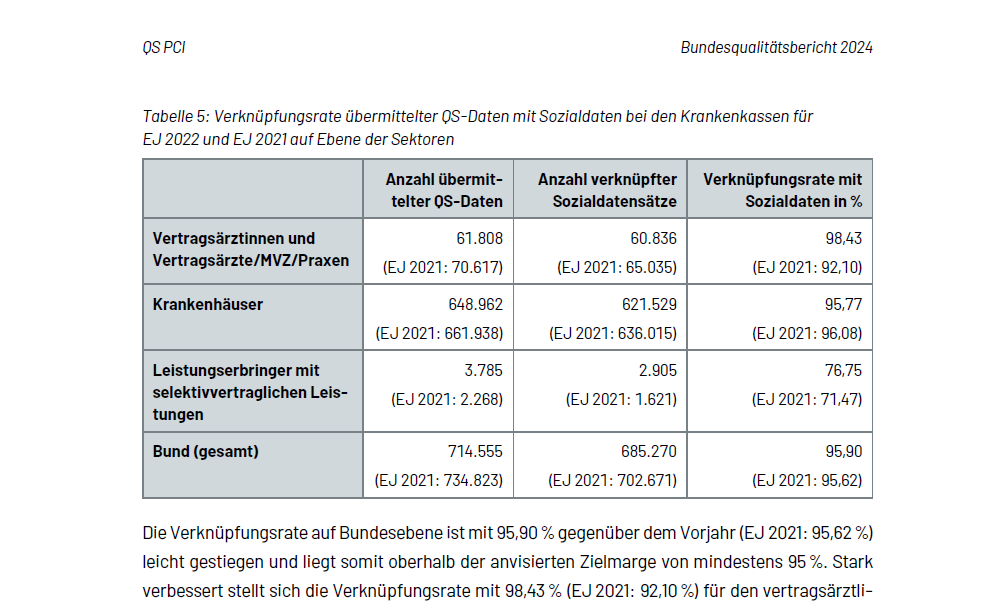
Rund 2.000 Tabellen, die Grafiken und der Fließtext dazwischen entstehen für den Bundesqualitätsbericht und die Qualitätsreports in einem Durchlauf, im verbindlichen Layout des Hauses. Dieselben Zahlen gehen zusätzlich als Excel-Mappe raus und über eine interne API an andere Systeme im Haus.
Ausgangslage
Der Bundesqualitätsbericht ist eine umfangreiche jährliche Veröffentlichung im gesetzlichen Auftrag. Wie er aussieht, steht vorher fest: Ein Berichtskonzept bestimmt die Tabellen samt Nummerierung, das Corporate Design gibt Vorlage, Hausschrift, Formatvorlagen und Farbpalette vor. Auswertung, Datenaufbereitung und der Export nach Word waren bis dahin sehr aufwändig, und weil vieles davon von Hand lief, fing man sich in jedem Berichtszyklus neue Fehler ein.
Word ist dabei das verbindliche Zielformat, und die ganze Aufbereitung ist darauf ausgelegt: Die Einzelstücke müssen sich später in ein großes Dokument einfügen, mit Querverweisen und durchlaufender Nummerierung.
Ziel
Eine Lösung, die über den aktuellen Bericht hinaus für die kommenden Jahre wiederverwendbar bleibt: reproduzierbar, wartungsfreundlich und so geschrieben, dass die Mitarbeitenden des IQTIG sie selbst nachvollziehen und pflegen können.
Lösung
Ein Jahr weiterstellen ist eine Zeile am Kopf des Hauptskripts. Danach lädt der Lauf die Daten aller einbezogenen Jahrgänge aus den jahresweise getrennten Datenbanken, rechnet die fachlichen Kennzahlen und baut daraus alle Tabellen und Grafiken.
Raus kommt je Tabelle und je Grafik ein einzelnes Word-Dokument im Corporate Design, dazu ein Gesamtdokument in Berichtsreihenfolge, eine Excel-Arbeitsmappe mit den standortbezogenen Ergebnissen und einem zweiten Blatt für unvollständige Meldungen, und ein vorbereiteter Datenstand für die API.
Der Fließtext kommt mit. Die Templates schreiben auch die begleitenden Sätze, mit den Zahlen direkt aus den Daten statt eines Platzhalters, den nachher jemand in Word ersetzt. Das spart die Nacharbeit und erledigt die häufigste Fehlerquelle gleich mit: dass die Zahl im Text nicht mehr zur Tabelle passt.
Ergebnis
„Die Auswertungen, Datenaufbereitungen und der Export des Bundesqualitätsberichts in Word waren stets sehr aufwändig. Die Umsetzung der gesamten Pipeline in R entlastet die Mitarbeiter des IQTIG, reduziert das Fehlerpotenzial erheblich und ist dank einer klaren und einfachen Programmierlogik eine wartungsfreundliche und nachhaltige Lösung für die kommenden Jahre. Vielen Dank, Stefan, für die professionelle und stets fristgerechte Umsetzung sowie die freundliche Betreuung!“
Wo es knifflig wurde
Dieselbe Tabelle in Word und in Excel
Dieselben Tabellen, die als formatierte Objekte nach Word gehen, werden zusätzlich als Arbeitsmappe gebraucht, einzeln und mehrere untereinander auf einem Blatt. Der einfache Export schreibt nur die Rohwerte, und damit gehen genau die Teile verloren, die die Tabelle lesbar machen: die Kopfhierarchie, die Gruppenzeilen, die Angabe, worauf sich eine Prozentzahl bezieht. Die Excel-Variante getrennt zu bauen hilft auch nicht, dann gibt es zwei Wahrheiten, die auseinanderlaufen, sobald sich eine Regel ändert. Quelle ist deshalb das bereits formatierte Objekt, und wenn mehrere Tabellen auf ein Blatt kommen, wird fortlaufend mitgerechnet, wo die nächste beginnt. Das ist selbst gebaut, weil es dafür keinen fertigen Weg gibt.
Ein Datenmodell, das sich jedes Jahr ein Stück verschiebt
Ausgewertet werden immer mehrere Jahrgänge nebeneinander, und die Daten liegen getrennt und haben nicht dasselbe Schema: Spalten wurden umbenannt, Felder kamen später dazu, ein Jahrgang liegt als Datei statt in der Datenbank und in einer anderen zeitlichen Auflösung. Eine Query über alle Jahre gibt es nicht, und alles auf das neueste Schema zu mappen scheitert daran, dass ältere Jahrgänge manche Felder schlicht nicht haben; die müssen fachlich hergeleitet werden. Mit dem Schema ändert sich außerdem das Regelwerk: Einzelne Anforderungen gelten erst ab einem bestimmten Jahr, andere dürfen bis zu einem Stichtag über einen Ausnahmetatbestand als erfüllt gelten. Am Ende stehen die Jahrgänge trotzdem vergleichbar in einer Tabelle nebeneinander.
Technische Umsetzung
Rechnen und Formatieren sind getrennt. Die Tabellenfunktionen liefern nur Werte, das
Rmd-Template entscheidet über Kopfzeilen, Spaltenbreiten, verbundene Zellen und Beschriftung. Der
Word-Export läuft über officedown und officer gegen die Referenzvorlage
des Hauses: Die Templates rufen die benannten Formatvorlagen auf, statt selbst zu formatieren, und
setzen Bookmarks für die automatische Nummerierung. flextable macht die eigentliche
Tabellenarbeit: mehrzeilige Kopfbereiche, Gruppenzeilen als Zwischenüberschriften, bedingte
Formatierung und die Seitenumbrüche, auf die es im gedruckten Bericht tatsächlich ankommt.
Ein Template wird je Modul in einer Schleife wiederverwendet, und für das Gesamtdokument werden
dieselben Templates als Child-Dokumente eingebettet, statt sie ein zweites Mal zu schreiben.
targets merkt sich, welche Eingangsdaten sich geändert haben, und rechnet nur die
betroffenen Targets neu. Bei einer Korrekturschleife kurz vor Abgabe ist das der Unterschied
zwischen ein paar Minuten und allem von vorn.
Zwei Grafiken bekommt man weder mit ggplot2 allein noch mit Word hin. Die Übersicht
über alle Standorte hat ihre interessante Information am Rand, weil fast alle durchgehend
erfüllen; sie wird deshalb aus mehreren Teilen zusammengesetzt, deren Verbindung aus den Daten
berechnet wird. Das Flussdiagramm zum Verlauf der Auffälligkeiten existiert zunächst nur im
Browser und kommt als Vektorgrafik aus einem Headless-Browser, weil ein Screenshot die falsche
Auflösung und die falsche Schrift hätte. showtext sorgt dafür, dass die Hausschrift
in den Grafiken genauso steht wie im Text.
Die Ergebnisse eines Jahrgangs gehen zusätzlich als JSON an andere Systeme im Haus, über eine API
mit plumber2. Der API-Container liest ausschließlich das Datenobjekt, das der
geprüfte Jahreslauf am Ende schreibt, und hat selbst keinen Datenbankzugang. Er kann also nichts
ausliefern, was nicht durch die Prüfung gegangen ist.
Betrieb und Weiterentwicklung
Der Jahreslauf wird von Hand gestartet. Ein neues Jahr bedeutet eine Datenbankverbindung und drei Excel-Zulieferungen mehr im Kopf des Hauptskripts. Die Stellen sind kommentiert, aber es ist eine Codeänderung und keine Konfiguration.
Abgesichert ist der Lauf über zwei Prüfungen, die an der fachlichen Aussage ansetzen statt an
einzelnen Funktionen. Nach dem Build wird geprüft, ob Zahlen, die in mehreren Tabellen vorkommen,
übereinstimmen und ob Teilsummen die Gesamtsumme ergeben; zurück kommt eine Liste der auffälligen
Module. Und vor jedem Rendern wird kontrolliert, ob eine Tabelle unerwartete NAs oder
leere Zellen enthält. Dass es diese Prüfungen gibt, hat einen Grund: Zahlendreher zwischen zwei
Tabellen waren ein reales Problem.
Alles läuft im Haus, ohne Cloud-Dienste: interne Datenbanken, interne API, die hauseigene
Zertifikatskette im Container. R-Version und Paketversionen sind über das Base-Image und
renv gepinnt.
Entwicklung und jährliche Anpassung liegen bei mir. Jedes Jahr verschiebt sich etwas: ein Feld kommt dazu, eine Regel greift erst ab einem Stichtag, ein Modul wird umbenannt. Der wiederkehrende Teil der Arbeit ist, das nachzuziehen, ohne die Ergebnisse der Vorjahre zu verändern.